A Compute Unified Device Architecture CUDA de 2006
Em 8 de novembro de 2006, a empresa estadunidense Nvidia anunciava publicamente a tecnologia Compute Unified Device Architecture (CUDA), possibilitando a utilização dos recursos de processamento paralelo das GPUs em aplicações de uso geral.
Na segunda metade da primeira década do novo milênio, a indústria de computadores começaria a testemunhar uma transformação importante na maneira como os processadores gráficos poderiam ser utilizados.
Até então, as GPUs (Graphics Processing Units), desenvolvidas principalmente para acelerar a geração de imagens, animações e ambientes tridimensionais, eram utilizadas predominantemente em aplicações gráficas e jogos eletrônicos. A empresa norte-americana NVIDIA, entretanto, enxergaria nesses processadores um potencial muito maior, concebendo a possibilidade de aproveitar sua capacidade de processamento paralelo para executar também tarefas de uso geral, incluindo cálculos científicos, simulações e processamento de grandes volumes de informações.
Isso faria com que, em 8 de novembro de 2006, a NVIDIA anunciasse oficialmente o CUDA (Compute Unified Device Architecture), uma arquitetura de computação paralela associada a um ambiente de desenvolvimento que permitiria aos programadores utilizar os recursos de processamento das GPUs em aplicações que não estivessem necessariamente relacionadas à geração de imagens.
A novidade representaria uma mudança significativa, ao possibilitar que desenvolvedores programassem os núcleos de processamento das placas gráficas utilizando uma abordagem baseada na linguagem C, em vez de depender exclusivamente das interfaces tradicionalmente destinadas à computação gráfica. Essa mudança conceitual permitiria que pesquisadores e desenvolvedores executassem cálculos matemáticos complexos com uma velocidade muito superior à dos processadores tradicionais.
GPU NVIDIA GeForce 8800 GTX
Esta tecnologia chegaria acompanhada de uma importante inovação na arquitetura dos processadores gráficos da empresa, a GPU NVIDIA GeForce 8800 GTX (baseada na arquitetura G80), uma das primeiras placas compatíveis com CUDA, lançada no mesmo dia 8 de novembro de 2006.
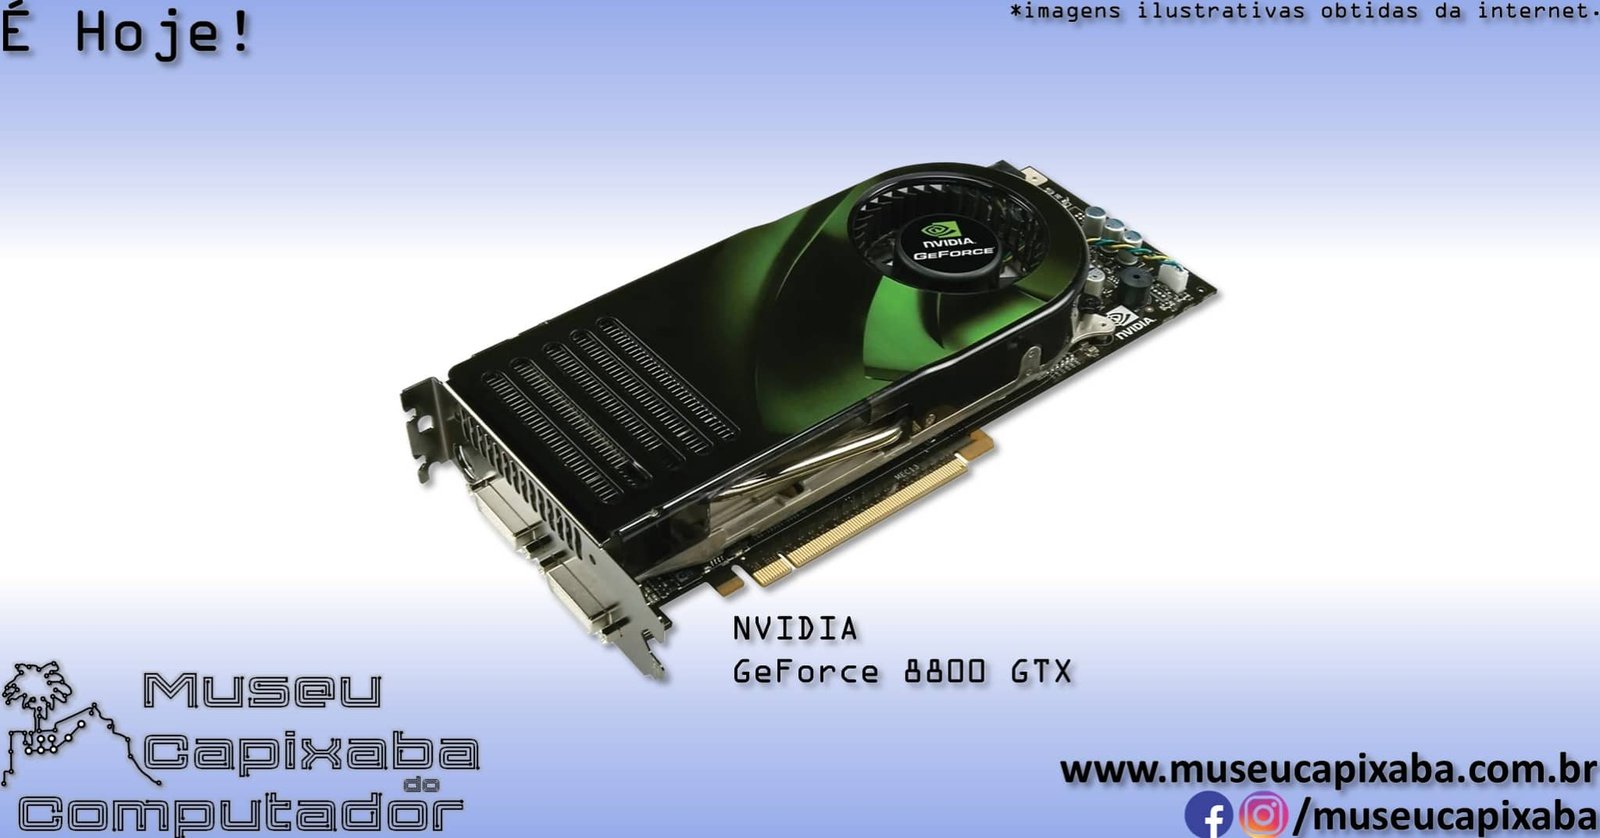
Seu projeto empregava 128 processadores de fluxo (stream processors) organizados em uma arquitetura de shaders unificados, na qual os mesmos recursos de processamento poderiam ser utilizados dinamicamente para diferentes tarefas gráficas e computacionais. Essa organização substituiria a divisão rígida entre unidades especializadas no processamento de vértices e pixels, proporcionando maior flexibilidade e aproveitamento do hardware.
Mas disponibilização da tecnologia para um público mais amplo ocorreria em etapas. Em 16 de fevereiro de 2007, a NVIDIA distribuiria uma versão beta pública do CUDA SDK (Software Development Kit), juntamente com seu compilador para a linguagem C, que permitiria a escrita de códigos utilizando linguagens populares como C e C++. Posteriormente, em 26 de junho de 2007, seria disponibilizada oficialmente a versão 1.0 do CUDA Toolkit, reunindo compilador, ferramentas de desenvolvimento, bibliotecas e exemplos de programação para facilitar a criação de aplicações capazes de utilizar o processamento das GPUs.
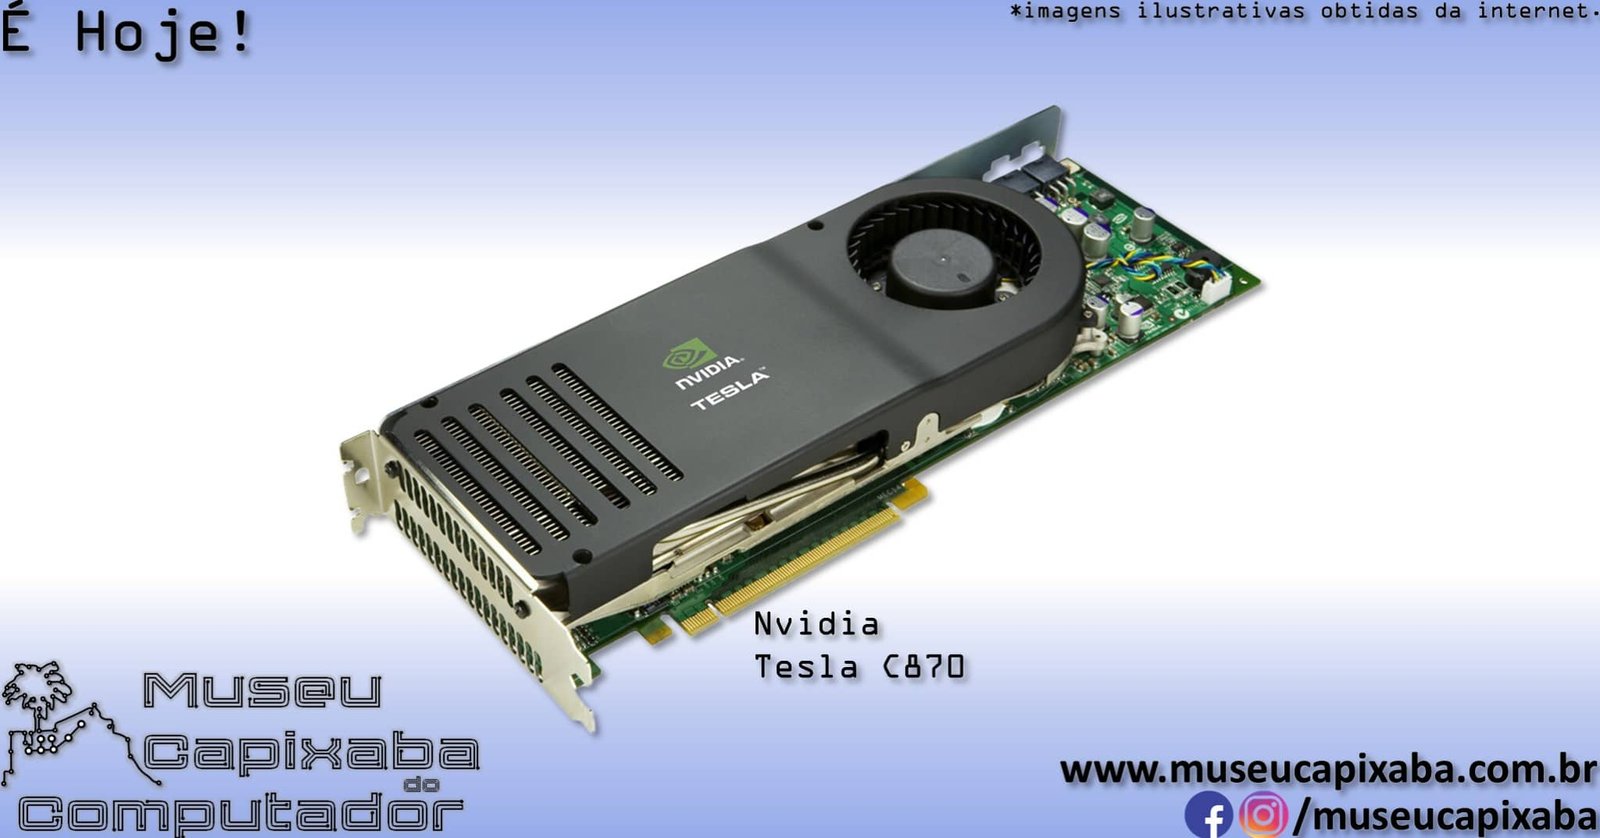
Ainda em 2007, a NVIDIA apresentaria sua linha Tesla, que teria como primeiro modelo a Nvidia Tesla C870, especialmente desenvolvida para computação de alto desempenho (HPC – High Performance Computing) que, diferentemente das placas GeForce (voltada aos jogos), não possuíam saídas de vídeo físicas, sendo destinadas a estações de trabalho, servidores e centros de pesquisa. Utilizando CUDA, essas soluções permitiriam acelerar operações matemáticas complexas, contribuindo para pesquisas em áreas como descoberta de medicamentos, diagnóstico por imagens médicas, engenharia, física e previsão meteorológica.
A evolução da plataforma continuaria com o lançamento do CUDA 2.0, em 22 de agosto de 2008, que ampliaria os recursos disponíveis aos programadores, incluindo suporte ao processamento de números em precisão dupla, importante para cálculos científicos que exigiam maior exatidão numérica. As versões seguintes acrescentariam novos recursos de programação, bibliotecas, ferramentas de depuração e otimização, além de compatibilidade com arquiteturas gráficas cada vez mais avançadas. Em 19 de março de 2010, por exemplo, seria disponibilizado o CUDA Toolkit 3.0, que incorporaria suporte à arquitetura Fermi.
Com chegada da década de 2010, a plataforma ganharia ainda mais relevância com a ascensão da inteligência artificial e do aprendizado de máquina, tornando-se a base essencial para o treinamento de grandes modelos de redes neurais profundas. Sem o suporte desse ecossistema de processamento paralelo, a revolução moderna dos assistentes virtuais e geradores de conteúdo teria levado muito mais tempo para se concretizar.
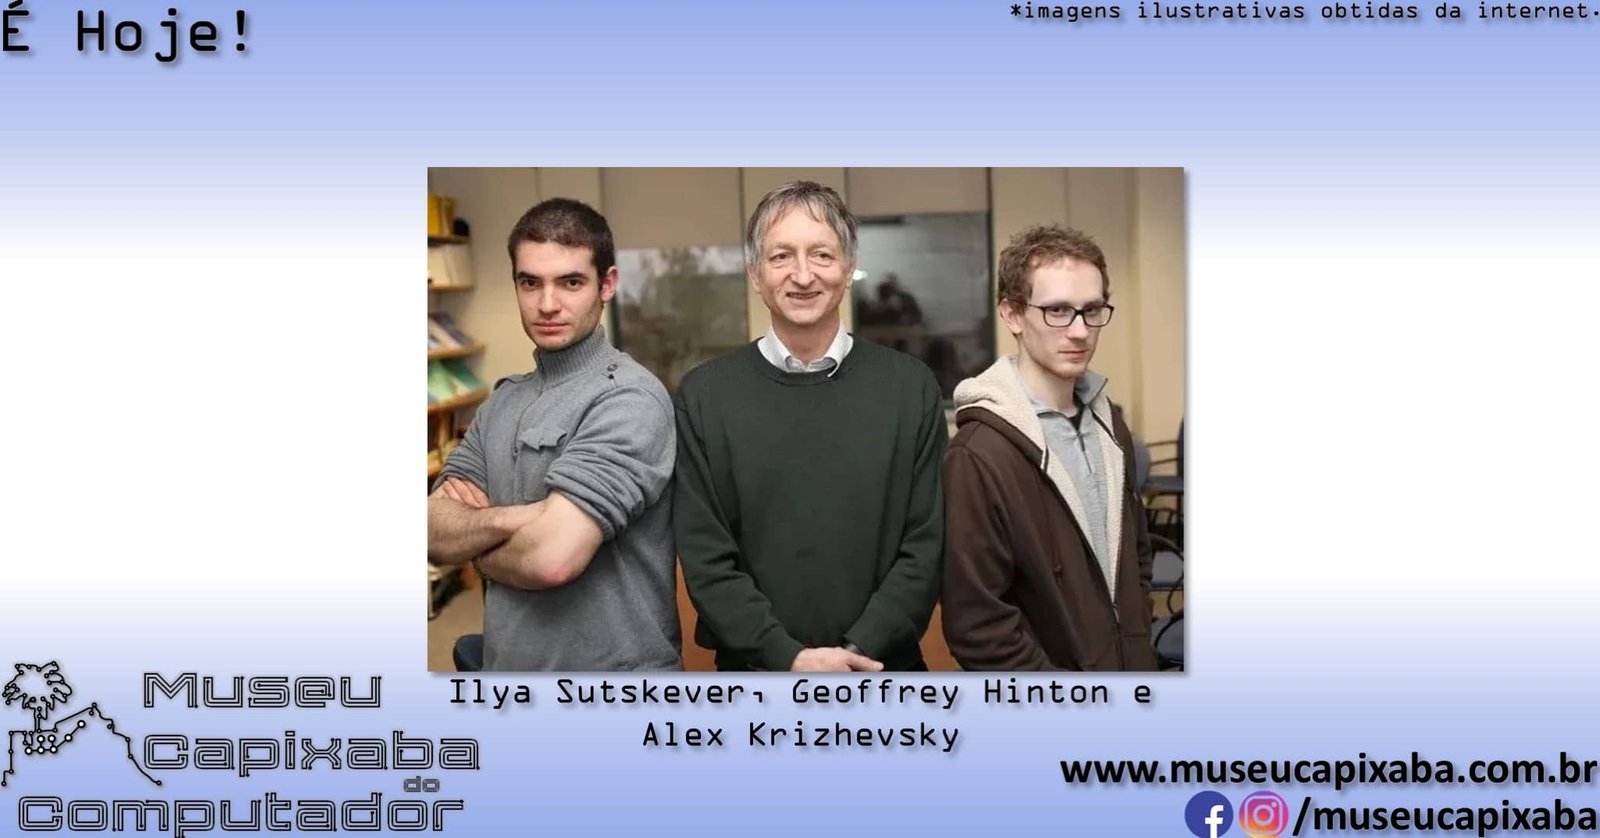
Um dos momentos mais importantes da história do CUDA ocorreria em 2012, quando pesquisadores utilizariam placas gráficas NVIDIA para treinar a rede neural AlexNet, desenvolvida por Alex Krizhevsky, Ilya Sutskever e Geoffrey Hinton, cujo sistema alcançaria resultados expressivos na competição ImageNet, destinada ao reconhecimento e à classificação de imagens, superando significativamente os métodos tradicionais utilizados até então. O episódio contribuiria para impulsionar o interesse mundial pelas redes neurais profundas e pela inteligência artificial, demonstrando o potencial das GPUs para executar os enormes volumes de cálculos exigidos por essas tecnologias.
Apesar de ter nascido voltada para o mercado corporativo e científico, a novidade também traria benefícios diretos aos computadores pessoais. Softwares de edição de vídeo, compactação de arquivos e renderização tridimensional passariam a acelerar suas tarefas diárias por meio das GPUs domésticas, com os usuários comuns vindo a aperceber ganhos de desempenho em aplicações cotidianas que antes sobrecarregavam apenas o processador principal do sistema.
A partir desse período, a CUDA passaria a ocupar uma posição central no desenvolvimento da computação acelerada, sendo utilizada em aplicações de inteligência artificial, aprendizado de máquina, processamento de imagens, simulações científicas, modelagem climática, análise de dados e supercomputação. Sua evolução acompanharia sucessivas gerações de processadores gráficos da NVIDIA, incorporando novas funcionalidades e bibliotecas especializadas, além de ferramentas que facilitariam o desenvolvimento de programas cada vez mais complexos.
E você, já utilizou a tecnologia CUDA em alguma aplicação específica?
Clique aqui e deixe seu comentário no final desta postagem! Sua participação é muito importante pra nós!
Vídeo(s):
*legendas disponíveis nos controles do Youtube, na opção “⚙ >> Legendas/CC >> Traduzir automaticamente”.
Mais em:
- A GPU Nvidia GeForce 256 de 1999
- A GPU Nvidia GeForce FX GeForce5 de 2003
- O chip 3dfx Voodoo Graphics 3D de 1995
- O acordo entre a Nintendo e a Silicon Graphics de 1993
- O chip Nvidia Tegra de 2008
- O Microsoft DirectX de 1995
*As imagens utilizadas nesta postagem são meramente ilustrativas e foram obtidas da internet, podendo conter direitos autorais.
Quer nos ajudar com doações de itens para o acervo do Museu Capixaba do Computador – MCC?
Entre em contato conosco por meio dos canais de comunicação identificados nos ícones abaixo, ou ainda por quaisquer uma das nossas redes sociais listadas no topo da página.
 |  |  |  |
As doações também poderão ser entregues diretamente na sede do museu, neste endereço.
Para refrescar a memória e te ajudar a identificar alguns itens que buscamos, aqui você encontra nosso álbum de “Procura-se” .
Colabore você também com o primeiro museu capixaba dedicado à memória da tecnologia da informação!
Doe seus itens sem uso. Você ajuda a natureza e dá uma finalidade socialmente útil pra eles!